Фахівець зі штучного інтелекту Ендрю Нґ закликав зосередитися на якості даних
Ендрю Нґ пояснив, чому для прикладного ШІ важливіші якісні дані, послідовна розмітка та цільове виправлення помилок.
Фахівець зі штучного інтелекту Ендрю Нґ заявив, що для багатьох практичних застосувань ШІ ефективнішим підходом може бути не нарощування обсягів даних і моделей, а систематичне поліпшення навчальних наборів даних. Про це співзасновник Google Brain і засновник Landing AI розповів в інтерв’ю IEEE Spectrum.
Нґ називає цей підхід data-centric AI — дисципліною систематичного створення та вдосконалення даних, необхідних для роботи системи штучного інтелекту. За його словами, протягом останнього десятиліття розробники переважно зосереджувалися на вдосконаленні коду та архітектур нейронних мереж, тоді як для багатьох прикладних завдань продуктивніше залишити архітектуру сталою й працювати над якістю даних.
Якісні дані замість великих наборів
За оцінкою Нґ, масштабування моделей і далі має перспективи, зокрема для мовних моделей та майбутніх базових моделей комп’ютерного зору. Водночас обробка відео потребує значно більших обчислювальних ресурсів, ніж токенізований текст, тому розвиток великих моделей для відео стримує вартість і пропускна здатність обчислень.
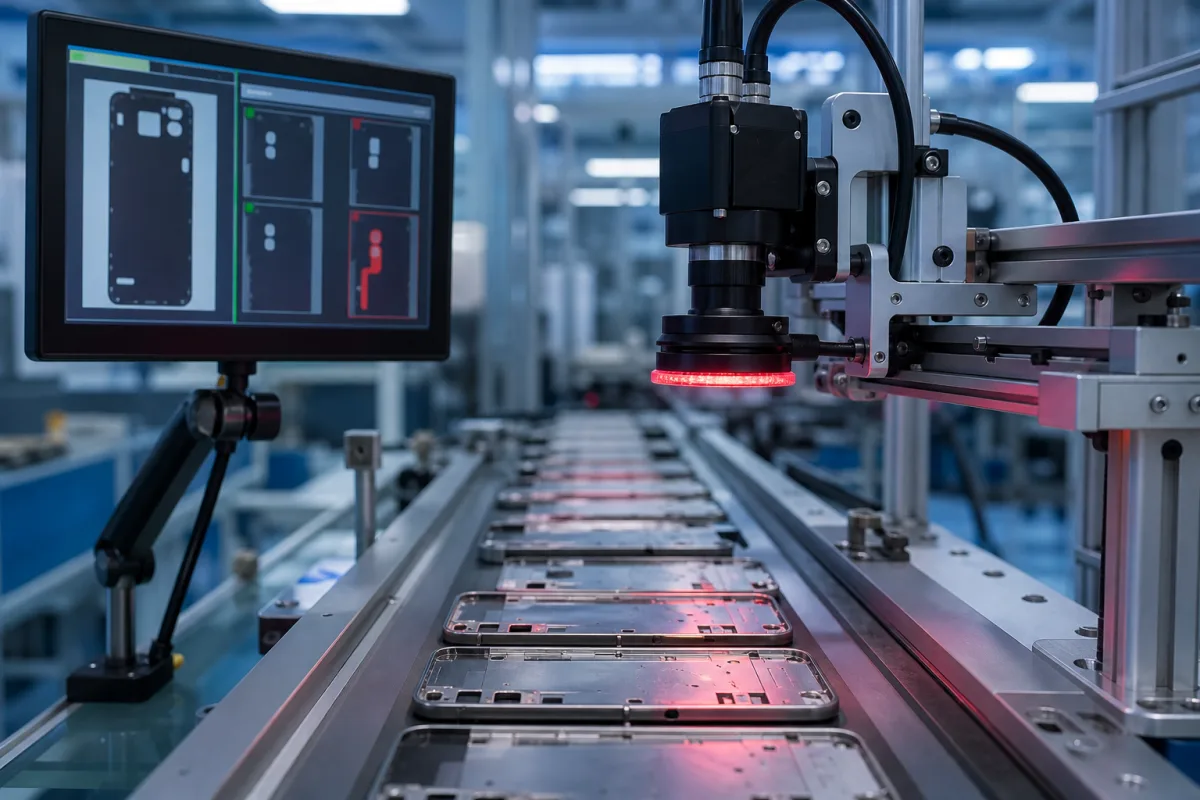
Водночас підхід із дуже великими наборами даних не підходить багатьом галузям, де таких масивів просто немає. Нґ зазначив, що для систем візуального контролю дефектів може бути корисним навіть набір із 50 ретельно відібраних прикладів. У Landing AI для таких завдань застосовують попередньо навчену версію RetinaNet, але основний акцент роблять на відборі зображень для донавчання та послідовному маркуванні даних.
Виявлення помилок у розмітці
Нґ звернув увагу, що розмітники можуть по-різному визначати правильну мітку для одного прикладу. Замість того щоб компенсувати таку неузгодженість простим збільшенням масиву даних, він пропонує використовувати інструменти, які виявляють проблемні підмножини. Наприклад, якщо серед 10 тисяч зображень 30 прикладів одного класу позначені непослідовно, їх можна швидко перевірити й перемаркувати.
На його думку, цілеспрямоване поліпшення даних також може допомагати працювати з упередженістю систем. Якщо модель гірше працює лише з певною частиною набору, коригування саме цієї підмножини даних може бути точнішим рішенням, ніж зміна всієї архітектури нейромережі.
Синтетичні дані та виробництво
Синтетичні дані Нґ назвав одним з інструментів такого підходу. Їх можна застосовувати, коли аналіз помилок показує слабку роботу моделі з конкретним видом дефекту, наприклад точковими слідами на корпусі смартфона. Водночас він радить спершу розглянути простіші кроки: аугментацію даних, узгодження розмітки або збір додаткових прикладів на виробництві.
Платформа LandingLens, розроблена Landing AI, допомагає виробникам створювати моделі комп’ютерного зору для візуального контролю. Компанія навчає клієнтів завантажувати й розмічати дані, тренувати моделі та оновлювати їх у разі зміни умов на виробництві, зокрема через дрейф даних.